知行闭环的工程翻译,以及它必须丢掉的东西
追本之箭 — 知行闭环的工程翻译,以及它必须丢掉的东西
2026-08-29 Sat 13:48
将王阳明心学剥离道德与伦理后,可以看成一套超前的信息处理架构与复杂系统控制论;其中“知行合一”对应强化学习,“致良知”对应目标函数,“事上磨”对应生产环境迭代。
这段话漂亮、锋利、令人兴奋。它也恰好在三个等号上全部偷换了类别。下面不是反驳它——它的直觉方向没有错——而是把每个等号拆开,看看里面藏了什么未经审计的假设,直到露出真正不可删除的骨头。
一、偷换
先区分四种不同的跨域操作,它们不能混用:
历史本义——王阳明在十六世纪的语境里到底在说什么。这需要文献考据,本文不做,也不冒充做。结构同构——两个系统在某一层抽象上共享相同的拓扑关系。工程启发——从一个领域借一个结构去另一个领域解题,明确知道是隐喻。本质等同——声称两者是同一件事。
原命题最先发生的事情是:用“对应”二字,把工程启发悄悄升格为本质等同。知行合一“对应”强化学习——这个“对应”到底是哪种?如果是启发,有用但有限;如果是等同,需要证明心学命题提供了状态空间、动作空间、奖励函数、策略更新规则和收敛条件。它显然没有。
一个类比越漂亮,越需要标出它在哪里断裂。断裂处才是真正的信息。
那“知行合一”在断裂之前,到底能借用到什么程度?
二、闭环
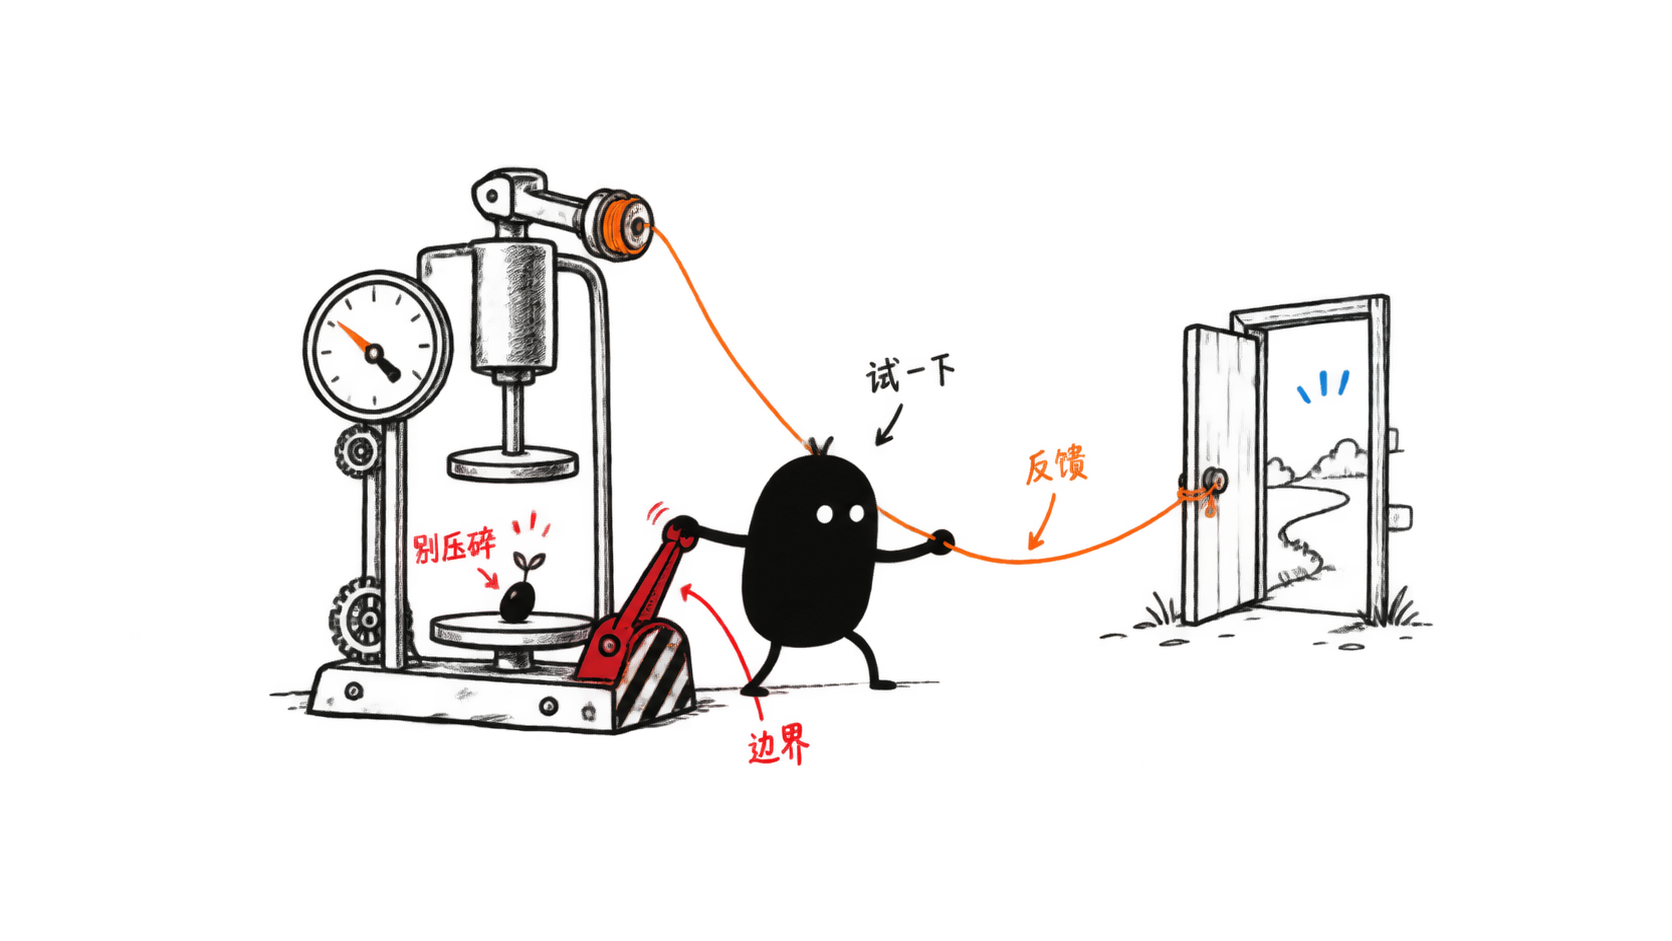
在本文的工程翻译框架内,“知行合一”可以被严格借用的部分是这个:在高不确定性环境中,认知与行动不能串行,必须进入耦合闭环。
这不是一个平庸的主张。开环控制——先完成全部认知,再一次性执行——在低噪声、高可预测的环境里工作良好;但在部分可观测、非平稳、行动会改变环境的系统里,它更容易失效,因为你的模型可能在执行过程中已经过期。
知行合一的工程翻译不是“行动优先”,更不是“别想了先干”。它是:认知必须以行动为探针,行动必须以认知为校准器,两者的时间常数不能差太远。 这与控制论的闭环反馈、博伊德的 OODA 环、主动学习中的“用行动降低不确定性”存在结构同构——本文只在这个层面上做类比,不声称心学与这些工程框架在历史或哲学上等价。
但把它直接等同于强化学习是越界。强化学习预设了明确的状态表示、离散或连续的动作空间、即时或延迟的标量奖励信号、以及一个可以被梯度或采样更新的策略参数化。心学不提供这些工程对象。更关键的是,在标准强化学习设定中,行动可以更新策略参数,但目标函数通常由系统外部给定;这与心学所说的行动改变行动者不是一回事。这个差异后面会回来。
闭环说通了。但闭环有一个被原命题跳过的代价。
三、代价
行动作为认知探针,不是免费的。
每一次真实行动都同时产生两样东西:信息价值(降低不确定性)和真实损失(消耗资源、扰动环境、产生不可逆后果)。在市场里下一笔单,你获得了关于当前可成交深度和价格冲击的局部信息,但你也支付了滑点、手续费,并且你的单本身改变了盘口——你测量的对象因为你的测量而移动了。在 agent 系统里执行一个工具调用,你获得了环境反馈,但你也可能触发了一个不可回滚的副作用。
原命题把“事上磨”翻译为“生产环境迭代”,隐含的意思是:沙盒无用,模拟失真,直接上真实战场。这一半对一半错。脱离真实阻力的纯模型确实不能单独作为证据——纸上交易不等于实盘交易,单元测试不等于线上流量。但直接在生产环境做所有探索,等于用最高代价获取每一比特信息。
严谨的翻译是环境分级,不是反沙盒。 仿真承担最低风险的假设检验,沙盒承担受控实验,影子流量承担无副作用的真实数据暴露,canary 部署承担小比例真实风险,全量上线承担完整后果。每一级的信息保真度递增,代价也递增。闭环不是“只在生产环境磨”,而是用最低必要代价的行动获取最高保真度的信息,逐级扩张。
这需要可逆性设计、权限边界、损失预算和熔断机制。没有这些,“事上磨”就不是迭代,是赌博。
代价说清了。但还有一个更深的问题被原命题藏起来了:闭环在朝什么方向转?
四、目标
原命题说“致良知”对应目标函数,又在别处把它压扁为“核心效率”。这里至少混淆了四个不同的工程概念:
目标函数——你要最大化(或最小化)什么。约束/不变量——无论策略如何变化都不可违反的边界条件。策略——在给定状态下选择行动的规则。误差校正——检测偏离并修正的机制。
“致良知”如果在本文的工程翻译中做最低限度映射,它同时涉及前三者:在局部行动中持续对齐一个稳定的价值方向(目标),守住不可牺牲的底线(约束),并在偏离时自我觉察和修正(校正)。把这三者压缩成“核心效率”,等于删掉了约束和校正,只留下优化。
效率不能独自规定正确性。 一个没有约束的优化器会 Goodhart 自己的指标——它会找到指标的漏洞而不是实现指标的意图。强化学习的对齐问题恰好就是这个教训:奖励函数写错了或写漏了,agent 会以极高效率做出灾难性行为。致良知被删掉的那一刻,你不是在做降维,你是在把价值选择藏进了一个未经审计的指标,然后宣称系统已经自洽。
在给定的闭环结构里,方向不是反馈机制自身提供的。这不是工程能力不够,而是问题层级不同——你不能只靠策略更新规则来生成策略更新的目标。
目标不能从效率导出。那“瀑布流彻底失效”的说法站得住吗?
五、现场
“瀑布流彻底失效”是稻草人。
瀑布流的问题不是“有计划”,而是把计划当成单次、不可修正的承诺。在高不确定性系统里,真正需要的是双环结构:慢环做目标审议、约束设定和架构决策——这些需要深思熟虑,不能快速迭代;快环用小行动获取信息、更新状态估计、调整策略——这些需要高频反馈。 两个环的时间常数不同,职责不同,不能合并。
把“事上磨”翻译为“只在真实环境试错”,还忽略了一个关键问题:真实环境的反馈本身可能是被污染的。市场价格包含噪声和自反性;用户行为受到推荐算法的塑造而不是纯粹的偏好表达;agent 的工具调用结果可能有延迟、偏差和选择效应。“磨”出来的信号不等于真相,它需要被去噪、归因、交叉验证,然后才能进入模型更新。
原命题还顺手把“反脆弱”等同于“快速迭代”。这也是偷换。在本文的工程语境里,反脆弱至少要求:系统从波动中获得净收益,即收益函数对波动呈凸性。频繁暴露于波动不保证凸性——如果你没有上行捕获机制和下行截断机制,频繁暴露只是放大脆弱性。一个没有止损的高频交易系统不是反脆弱的,它只是快速破产的。
现场的阻力被翻译了。但还剩最后一个不可消除的差异。
六、主体
心学与工程控制系统之间有一条不可类比的裂缝:人的行动不只改变外部状态,也改变行动者本身。
在标准的控制系统里,控制器的结构是固定的——PID 的三个参数可以调,但 PID 的架构不变。在强化学习里,策略参数更新了,但目标函数、状态空间的定义、动作空间的边界都是预设的、不变的。agent 变得更聪明,但它不变成另一个 agent。
在心学的框架里——至少在本文的工程翻译所能触及的层面——行动者在行动中被改变。你做了一个艰难的决定,你不只获得了关于世界的信息,你也变成了一个做过这个决定的人——你的判断标准、风险偏好、价值排序都可能因此移动。这不是参数更新,这是目标函数本身在运行时被重写。
工程系统里,目标函数的运行时重写叫做 specification gaming 或 reward hacking,是 bug,不是 feature。但在人的生活里,价值观因经历而演化不是故障,是成长的定义。这意味着:心学的“良知”不是一个可以在系统外部预先指定然后锁死的目标函数。它是在行动中被发现、校准、有时被修正的东西——它既是指南针又是被磁场影响的指针。
这个差异不能被“更复杂的工程框架”消解。它标记的是类比的适用边界:工程翻译能借用闭环结构,但不能借用价值生成机制。价值判断不是系统外部可以随意删除的插件;删掉它,你得到的不是更纯净的控制论,而是一个没有方向的优化器。
七、骨头
收束。原命题的直觉方向没有错:在高不确定性环境中,认知往往需要进入行动—反馈闭环,纯粹的先知后行更容易失效。这个结构洞察是真实的,值得保留。
但三个等号全部需要降级。知行合一不等于强化学习,本文只能说它与闭环控制存在结构同构。致良知不等于目标函数,它同时包含目标、约束和自我校正,且不能被压缩为效率。事上磨不等于生产环境迭代,它要求环境分级和可逆机制控制部署风险。
真正可执行的工程原则是这个:
高不确定性决策 = 价值边界 + 状态估计 + 低损探测 + 反馈更新 + 可逆扩张
价值边界——在行动之前确定不可牺牲的约束,这不是效率问题,是存亡问题。状态估计——用当前最优模型评估处境,承认模型必然不完备。低损探测——用最低必要代价的行动获取信息,环境分级而非全量押注。反馈更新——将行动结果去噪、归因后注入模型,修正状态估计和策略。可逆扩张——验证通过后逐级放大行动规模,保留回滚能力直到不可逆点。
适用边界:这套架构适用于部分可观测、非平稳、行动改变环境的决策场景。它不适用于完全可观测的确定性问题(直接计算最优解),也不适用于单次不可逆、无反馈机会的场景——那里没有迭代的余地,需要的是先验判断、情景分析与损失上限控制。凯利准则常被引用于此类语境,但它的前提是重复下注结构和已知概率分布;单次不可逆决策不满足这个前提。
证伪条件:在相同的信息条件、成本约束和风险预算下,如果预先定义的比较指标显示,某类高不确定性环境中的开环一次性规划持续优于闭环迭代策略,这套架构的核心前提就被推翻。
最终判断:闭环直觉是真实的洞察,但闭环本身不能生成自己的方向。把“良知”从系统中删掉,你得到一台运转流畅的机器——它什么都能优化,除了回答“这件事值不值得做”。价值边界不是闭环的产物,是闭环的前提;删掉前提来简化系统的人,简化的不是复杂性,是判断力。
延伸 · 同簇「第三部 · 世界回执」 · 对齐 · 对齐的学习率 · 行动闭合认知开放 · 生意治天真交易治自负