更新的部署债
追本之箭 — 更新的部署债
2026-08-20 Thu 07:02
起点:脑子更新了,人生没有
年轻 说:年轻不是年龄,而是世界递来预测误差时,你仍肯改模型。
系统与目标 说:目标只是罗盘;真正决定结果分布的,是每天反复运行的系统。
两句话交叉,会露出一个常被“我已经想明白了”掩住的断层:
模型已经更新,不等于运行模型的系统已经更新。
你承认旧判断错了,甚至能漂亮地解释自己为什么错;可下一次同样的情境到来,你仍按旧方式选择、回避、下注、讨好或拖延。
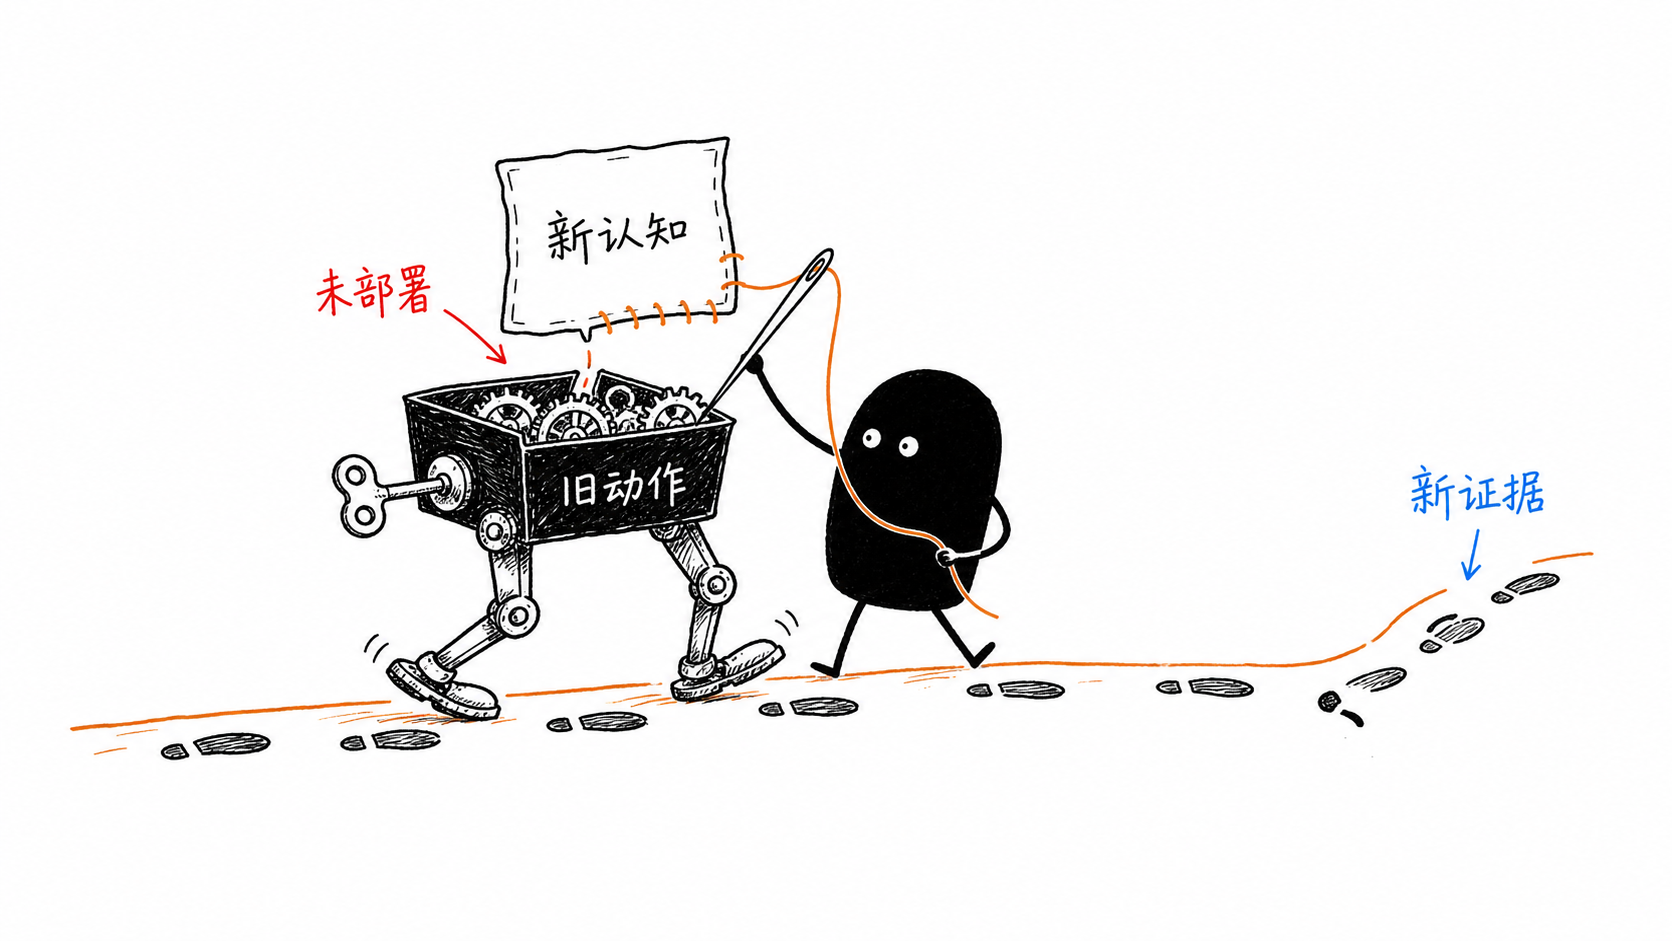
认知到了新版本,行为还在跑旧版本。
这不是虚伪,也不只是意志薄弱。它更像一笔工程债:源码改了,生产环境没有部署。
第一层:编译
观念不是行为。
观念更像一份源代码:它描述“我现在认为世界怎样运转”。系统则是编译后的执行物:触发条件一到,它不再重新讨论世界,只按既有规则分配注意力、时间、钱与动作。
世界模型 M
  → 决策规则 P
  → 环境与习惯 E
  → 重复动作 a
  → 结果分布 D
平时真正跑起来的,不是那句最新的道理,而是已经被编进 P 与 E 的旧结论:
- 你说风险重要,但日历里没有复盘窗口;
- 你说身体重要,但默认选项仍是熬夜;
- 你说不再讨好,可冲突一来,身体先替你道歉;
- 你说结果掺着随机,可每天仍用盈亏审判自己。
语言里的模型可以在一分钟内改变。
被环境、阈值、默认值和肌肉记忆固化的系统,不会跟着自动重编译。
“我知道了”只完成了源码修改;“我会不同地行动”才完成编译。
第二层:代偿
理解会给人即时奖励。
混乱突然有了名字,痛苦突然有了因果,过去突然能被解释。预测误差下降,大脑获得一种“已经处理”的松弛感。
但这份松弛可能恰好替代了改变。
看见问题
  → 得到解释快感
  → 主观张力下降
  → 失去改系统的压力
于是洞见出现一个反常功能:它没有推动迁移,反而替旧系统止了痛。
你越会分析自己,越可能精准地描述每一次复发;描述得越精准,越像已经站在问题外面。可会说出回路,不等于离开回路。地图甚至可能成为回路的新装饰。
这解释了为什么有些人读了很多、复盘很多、表达越来越锋利,人生的动作分布却几乎不变。
他不是没有更新。
他把更新消耗在了解释层。
第三层:回灌
系统不是被动执行模型。系统还决定你会继续遇见什么数据。
你沿旧规则行动,就会选择熟悉的人、熟悉的风险、熟悉的回报、熟悉的退路。旧动作制造旧环境,旧环境返回旧反馈,旧反馈再把刚更新的模型磨回原状:
新模型 M₁:我应该改变
旧系统 P₀:仍按过去采样
旧反馈 F₀:世界果然还是老样子
最终结果:M₁ 被回滚到 M₀
所以不部署的代价,不只是“知道却没做到”。
更狠的是:旧系统拥有生产证据的权力。
它每天都从自己熟悉的世界里采样,再拿这些样本告诉你:新的认识太理想,旧的做法才现实。
例如,你刚相信“边界不会自动毁掉关系”,却仍在每次不适出现前先让步。对方当然继续越线。随后旧系统指着结果说:“看吧,这段关系里根本不可能有边界。”
它先阻止实验发生,再拿没有反例当作正确证明。
未部署的洞见会被旧行为产生的数据反向吞掉。
第四层:迁移
认知更新要变成系统更新,至少要穿过四道门:
新判断
  → 新阈值:什么情况下必须改动作
  → 新默认:来不及思考时先做什么
  → 新环境:什么更容易,什么更困难
  → 新结算:以后用什么证据判断它有效
如果只改判断,不改阈值,旧动作会说“还没严重到需要变”。
如果只改阈值,不改默认,压力一来仍会自动回到旧路。
如果只改默认,不改环境,每次执行都要额外支付意志力,更新会慢慢破产。
如果前三者都改了,却仍用旧指标结算,新系统会被旧计分方式判成失败。
因此一次真实更新,必须留下可观察的迁移痕迹:日历多了一块不能被挪用的时间,账户多了一条风险上限,冲突出现时多了一句不再吞回去的话,决策记录里多了一个事前判据。
不是为了形式化一切。
而是为了让新模型第一次获得制造新证据的机会。
第五层:分布
看同一个触发再次出现时,动作概率有没有变。
部署强度
= P(新动作 | 旧触发, 无人监督)
 - P(新动作 | 旧触发, 更新之前)
这把“改变”从一句自我叙事,压回一个冷的判据:
- 不是你是否赞同新观点;
- 不是你是否为它感动;
- 不是你是否偶尔做对一次;
- 而是旧情境重现、成本重新出现、没人提醒时,下一步的概率分布是否已经偏移。
如果洞见只在复盘时成立,在现场永远失效,它还没有部署。
如果新动作只能靠持续自责维持,它只是人工热修复,还没进入系统。
如果环境撤掉提醒后仍会发生,阈值到了能自动触发,结果不好也不立刻回滚,那么更新才开始成为你的新版本。
真正属于你的认识,会在你来不及解释自己时替你行动。
第六层:归属
你以为“我”是我相信的那些话。
但对现实来说,“我”更接近一组稳定的状态转移概率:遭遇诱惑时我多大概率屈服,遭遇损失时我多大概率追涨杀跌,遭遇冒犯时我多大概率沉默,遭遇反例时我多大概率改模型。
自我 ≈ P(下一步动作 | 当前状态)观念只有进入这组概率,才进入了因果链。
否则它只是系统对自己的旁白:说得再真,也没有改变世界接下来会经由你发生什么。
这就是部署债的最深处。
欠的不是一次执行。
欠的是让真相取得因果权。
旧系统仍在决定下一步,新认识却只能站在事后解释;你把它叫作“我的认知”,其实它还没有获得成为“我”的权限。
终点:别用理解冒充改变
年轻,不只是还能被世界说服。
真正的年轻,是世界说服你之后,旧系统不再拥有永久运行权。
诊断表
| 症状 | 部署债 | 动作 |
|---|---|---|
| 能清楚解释问题,却反复做同一件事 | 源码已改,执行物未换 | 找到旧动作的触发器与默认值 |
| 每次复盘都很有收获,现场仍失效 | 洞见只活在解释层 | 为同类现场预写一个最小新动作 |
| 新认识很快又“显得不现实” | 旧系统仍垄断采样权 | 让新动作先制造一批新证据 |
| 靠自责才能维持改变 | 人工热修复,尚未系统化 | 改环境、阈值与默认选项 |
| 偶尔做对一次就宣布改变 | 把样本当分布 | 等同一触发重复出现再验收 |
三个该的姿态
✅ 每次更新都问“它要改哪条规则”:没有规则、阈值或默认值的变化,洞见还没离开语言。
✅ 把新动作当作采样器:先让新系统生产不同证据,再决定新模型是否站得住。
✅ 按重复触发下的行动概率验收:一次做到是事件,多次自动做到才是系统。
三个不该的姿态
❌ 用“我已经想明白了”提前结清改变的账。
❌ 让旧系统继续制造全部样本,再用旧样本否决新认识。
❌ 把每次复发都归咎于意志薄弱;很多时候,真正没改的是环境、默认值和结算方式。
证伪条件
如果人的显性认知一经改变,就会自动、稳定、无摩擦地同步改写习惯、环境选择、决策阈值与压力下的默认动作;或者行为系统不会反过来影响未来采样到的证据,那么“更新的部署债”不存在,本文机制不成立。
最后一句
你真正相信什么,不看你能把它说得多深。
看下一次旧世界按下同一个按钮时,
究竟是新认识替你行动,还是旧动作替你解释。
(箭到底了。)
延伸 · 同簇「第三部 · 学习率、罗盘、余量」 · 更新的余量 · 盲区里的学习率 · 贝叶斯调整 · 不能被系统化的年轻