买的不是 Mac,是回执
追本之箭 — 买的不是 Mac,是回执
2026-09-02 Wed 12:35
AI 产业正在出现两种不同的算力需求:大模型预训练需要大量矩阵计算,英伟达 GPU 集群仍是主力;Agent 后训练需要大量真实交互、环境运行和任务验证,Mac 集群有可能成为新的基础设施。
Agent 训练需要的,从之前的"超级计算中心",变成了成千上万个"数字员工工位"。 —— 刘飞,评 OpenAI 大规模采购 Mac mini/Studio 训练能操作电脑的 AI Agent
一、鱼塘
新闻先讲准。
OpenAI 过去几个月采购了数万台 Mac mini 与 Mac Studio——没接显示器,没配键盘,不是给员工的办公电脑,是无头桌面主机。每台装了完整的 macOS 和常用应用,可以随时恢复初始状态。Anthropic 也在通过 AWS 租用同类 Mac 算力。用途一致:强化学习,训练能看屏幕、点按钮、切应用、拖文件、遇错重新规划路径的 computer-use Agent。模型在上面练的不是下棋、不是对话,是操作电脑干活——填表、预订、整理文件、跨应用搬运数据、碰到弹窗和报错自行判断下一步。
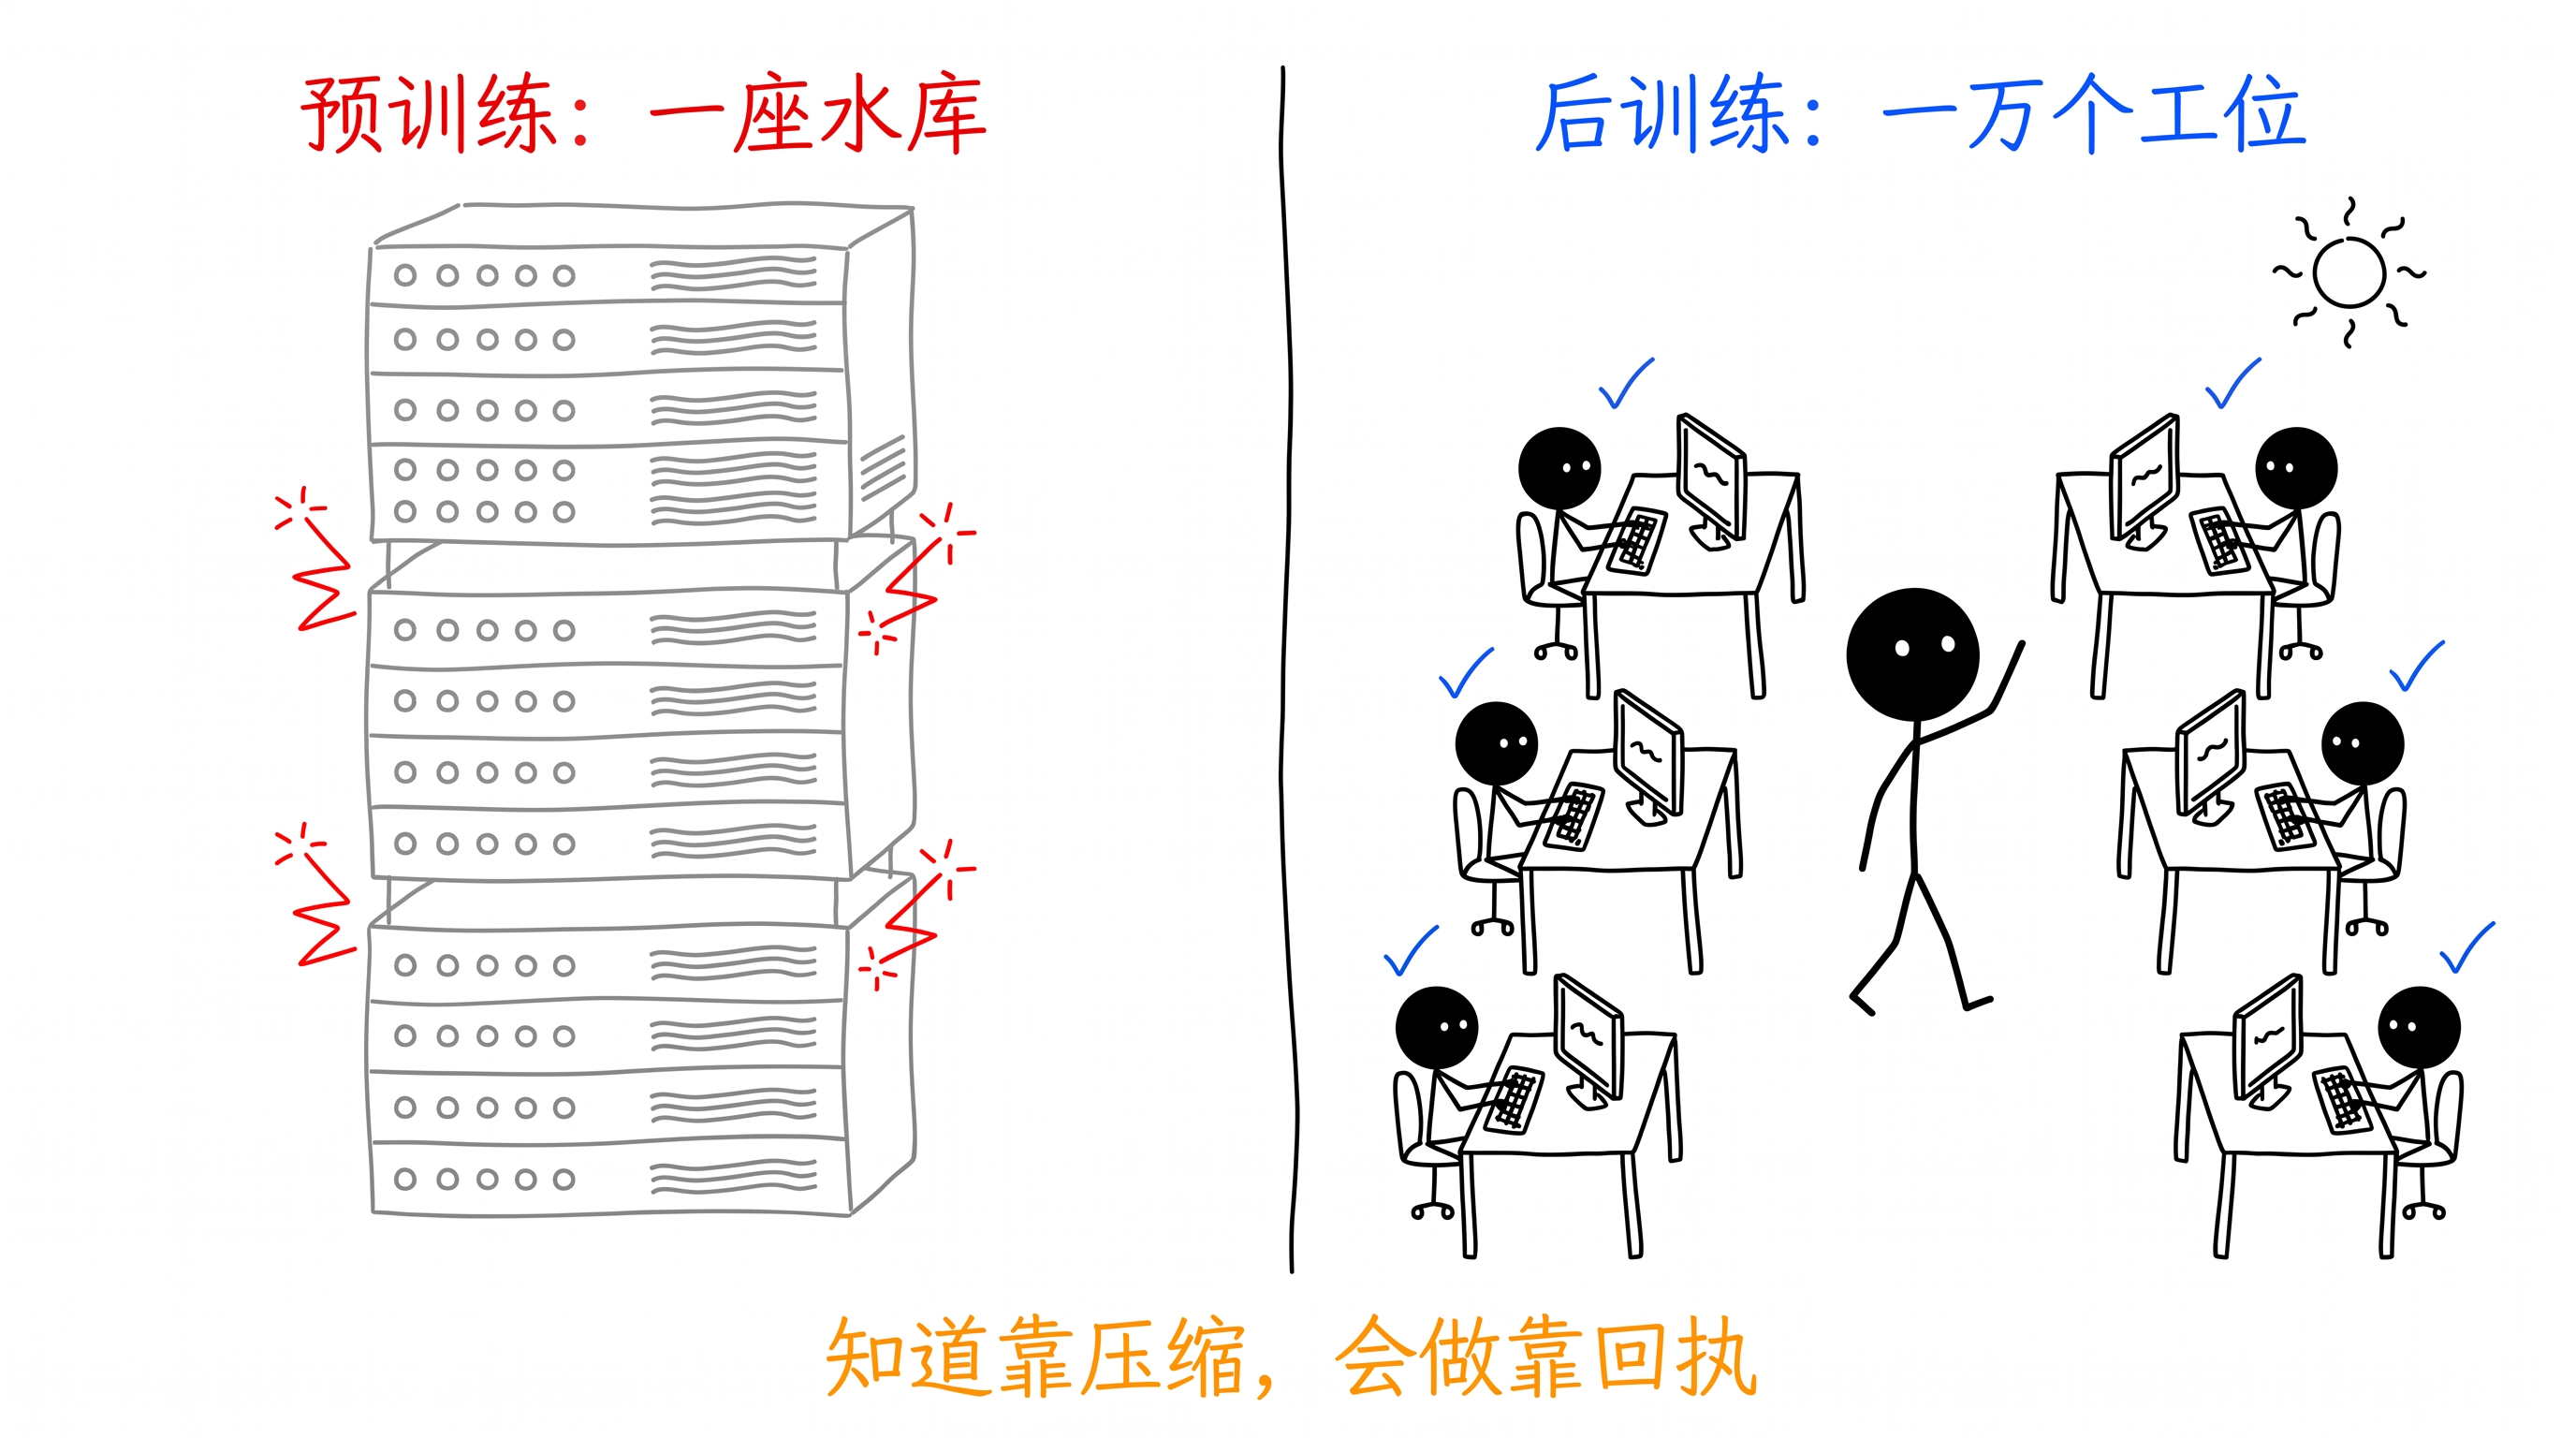
库克大概在偷笑,黄仁勋大概在皱眉——但戏剧性不是重点。重点是这笔采购揭示的产业转向:练 Agent 要的不是更大的算力池,是更多的操作环境。不是水库,是鱼塘——成千上万个装了完整操作系统、真实应用、可随时重置的"数字员工工位"。 水库存水,人人来打;鱼塘养鱼,得一口一口挖。两种基础设施,两套物理学。
为什么练 Agent 不能继续用 GPU 水库?
二、两半
因为智能有两半,吃的饲料不同。
预训练是压缩:把海量语料压进参数——吃数据,产"知道"。后训练是交互:在真实环境里行动、看结果、再行动——吃反馈,产"会做"。GPU 集群喂得了前半顿:矩阵乘法算得出词与词的共现概率。后半顿它喂不了——矩阵乘不出"点完那个按钮之后屏幕会变成什么样"。这个信号只有真实运行的操作系统才能给。
上限与下限两年前立过框架:预训练决定能力上限,后训练决定可用下限——那篇是理论推演,这篇是几十亿美元的产业实证。这条新闻是产业用真金白银投下的确认票:语料侧的军备竞赛见顶了,稀缺资产从数据换成了环境。 知道的上限,人人租得起同一批 GPU 来逼近;会做的下限,得自己一台一台攒出来。
环境到底供给了什么,值得当算力买?
三、回执
供给世界的回话。
强化学习的最小单元是一个闭环:动作发出,世界回应,信号回传。点了按钮弹没弹窗、拖了文件成没成功、报错之后换条路走不走得通——每一次回应都是一张收据,上面写着"你刚才那一下,成了还是没成"。没有这张收据,模型就不知道自己做对了没有,下一次遇到同样的岔路口还是瞎猜。
能动性从哪来立过人类版:vmPFC 靠"行动→结果"的闭环覆盖出厂瘫痪,能动性是收据攒出来的。Agent 后训练是这套回路的工业复刻。OpenAI 采购的不是 Mac,是批量的世界回执——几万台机器,就是几万个日夜不停的发条侦听器,每秒钟向模型签发一张"成了/没成"的回单。
语料里不是也有无数操作教程吗——为什么不够?
四、进屋
因为语料里全是门牌号。
名与知立过判决:名称是理解的门牌号,进过屋子才算拿到钥匙。教程写"点击设置图标",但真实世界里图标会挪位置、弹窗会遮挡、网络会超时、应用悄悄改版、屏幕分辨率不同导致布局错位——屋子里的东西,门牌号上一个都没写。 语料是一张精确到门牌号的城市地图,但地图不是城市,路上也不堵车。
读一万条操作说明的模型"知道"一切——哪个菜单在哪、哪个快捷键干什么、哪个按钮触发什么流程。跑过一万次真实任务的模型才"会做"——因为它进过那间屋子,被门夹过、被锁挡过、在黑暗中摸过墙壁。知与行之间隔着的,正是那间必须亲自推门进去的屋子。每一次推门,就是一次从门牌号到屋内实景的兑换。
这笔账,今天上午刚立过的判据怎么算?
五、残余
用残余测试算。
能力与兴奋上午刚立:判断积累还是消费,只看结束后留下什么可调用的残余。两种训练,两种残余。语料训练的残余是参数里的统计相关性——"知道什么和什么常一起出现",是概率层面的大概知道。环境训练的残余是轨迹——完整的"情境、动作、结果、修正"四元组,下一次遇到同类任务直接调用,不用重新摸索。前者是认出了门牌号,后者是走过了整条路。
AI 产业等于用真金白银公告了一件事:能力不能下载,只能在环境里长——这句话对硅基碳基一视同仁。 光有参数不叫能力,有可复现的行动轨迹才叫。OpenAI 买的每一台 Mac 都是一片土壤——参数是种子,种子不落地不会发芽。
工位买齐了,训练就通了吗?
六、裁判
还差最难的一环:验收。
工位好买,裁判难造。任务完成与否,谁说了算?"帮我订张机票"——订到了但贵一倍算成还是算败?"帮我写封邮件"——发出去了但语气冒犯算几分?"帮我整理桌面"——文件都归了但正在用的项目也被归档了,扣分还是判零?强化学习的真瓶颈从来不是环境数量,是奖励信号的质量。环境只提供"发生了什么"的事实,裁判才能判定"做得对不对"的价值。奖励太粗——只判"完成/未完成"——模型学不到细节;太细则计算成本爆炸;太主观则信号不可复现,今天满意明天不满意,模型无所适从。
精通失败立过发票制度:没有发票的失败是白疼。Agent 的每一次尝试也要开发票:哪个动作错了、错在哪个判断节点、下一步怎么改。开不出发票的环境再多,也只是让 AI 白忙——环境是纸,裁判才是笔。 纸可以批量采购,笔必须一支一支磨。几万口鱼塘买下来了,没有裁判,鱼塘里养的不是鱼,是噪声。
这面产业镜子,照到人身上是什么?
七、镜子
一份个人采购清单。
人的预训练早已平价:课程、书单、教程、播客,一键可达,全网同价。人的工位依旧稀缺:真实项目、真实客户、真实验收——有人用、有人骂、做砸了会疼的环境,买不到也搜不到。OpenAI 花几十亿买工位,你我花的不是钱,是时间——可时间的流向暴露了同一个问题:大多数人的"学习"其实在囤语料,越囤越心安,越囤越不敢出手。
产业的钱怎么流,个人的时间就该怎么配:买环境,别只买语料。项目大于课程,客户大于证书,发布大于收藏。
知道靠压缩,会做靠回执——语料的时代人人共享上限,环境的时代,下限才是身价。
盘点你今年花在学习上的钱和时间——几成买了语料,几成买了环境?然后学 OpenAI 花一次钱:给自己开一口鱼塘——一个真实运行、有人验收、错了会疼的小环境。工位不用一万个,一个就够,但必须真的通电。